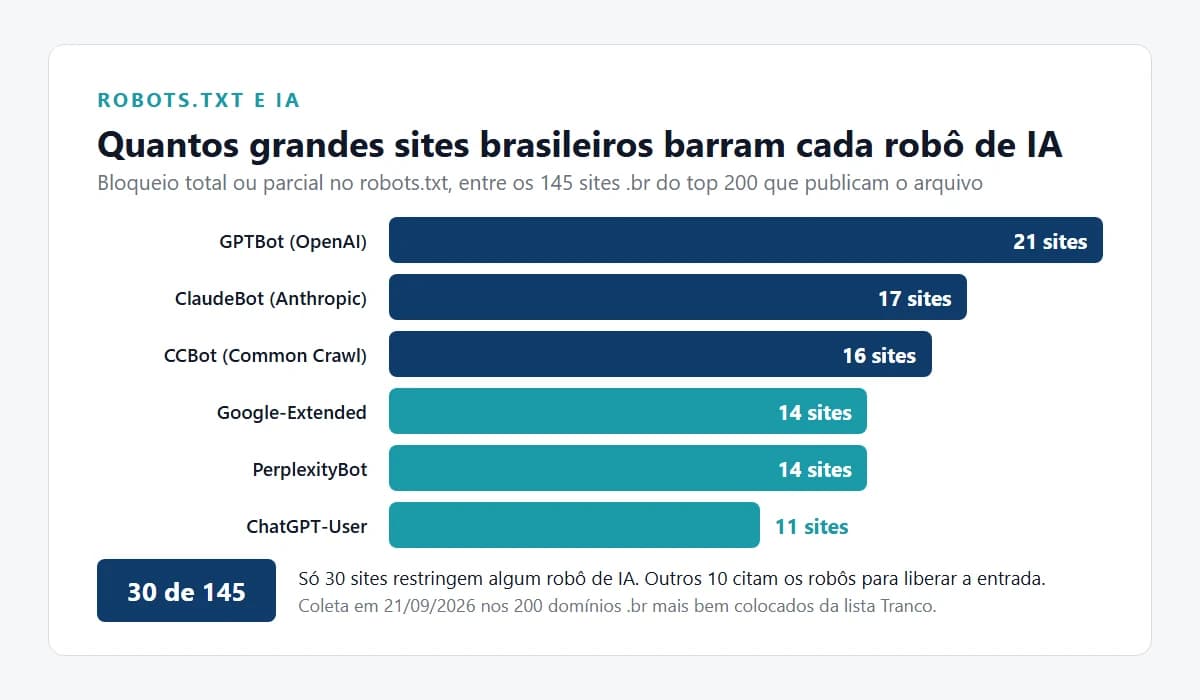
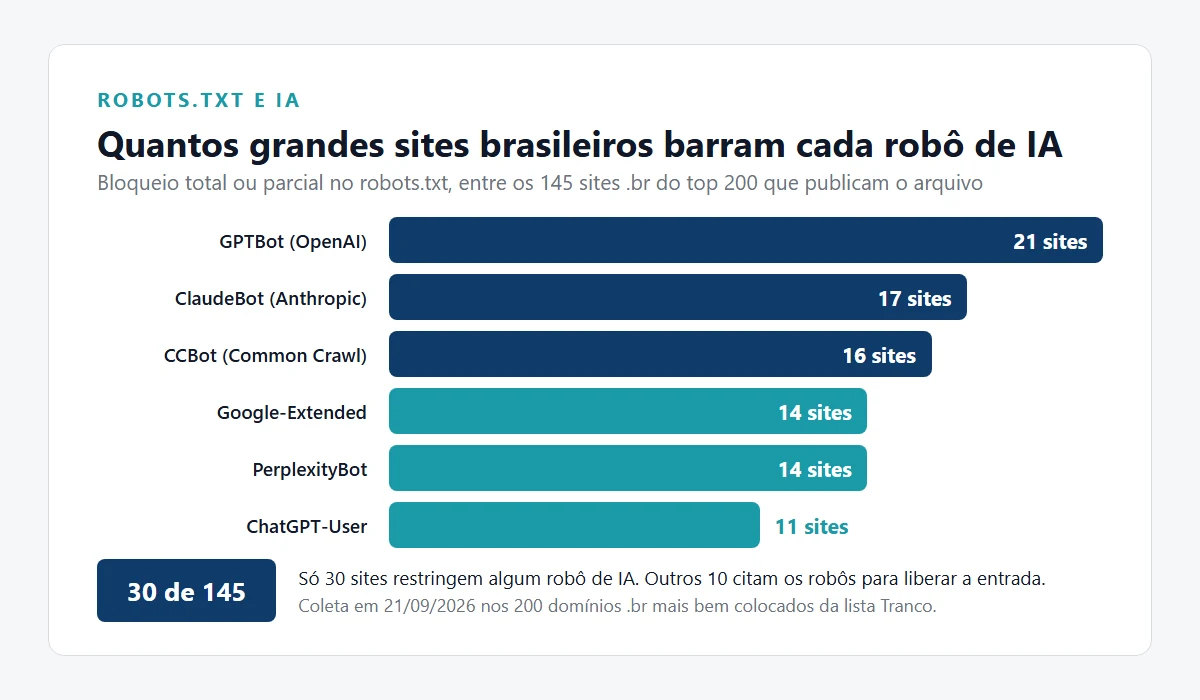
Baixei em 21 de setembro de 2026 o arquivo robots.txt dos 200 domínios .br mais bem colocados numa lista pública de tráfego e procurei, em cada um, os nomes dos 26 robôs que as empresas de IA usam para ler a web. Dos 145 sites que publicam o arquivo, 30 restringem pelo menos um robô de IA. Outros 10 citam os robôs pelo nome para fazer o contrário: liberar a entrada. E 105 não dizem nada, o que na prática é porta aberta.
O achado que eu não esperava está nos portais de notícia. UOL e Folha bloqueiam mais de 20 robôs de IA e poupam justamente o da OpenAI. A planilha com as 220 linhas da coleta está no fim do post.
Como fiz a coleta
A base é a lista Tranco, um ranking de domínios mantido por pesquisadores que combina várias fontes de tráfego e é usado em estudos acadêmicos de segurança. Baixei a lista de 21/09/2026 (identificador 64X5X), filtrei os domínios terminados em .br e fiquei com os 200 primeiros, tirando sites adultos. O primeiro da fila é o uol.com.br, na posição 561 do ranking mundial.
Para cada domínio, pedi o /robots.txt com e sem www. Onde a primeira tentativa falhou, repeti com outro cliente HTTP. Depois pedi o /llms.txt, o arquivo que alguns sites passaram a publicar para orientar modelos de linguagem. Em paralelo, fiz o mesmo em 20 endereços de veículos de notícia, porque vários deles moram em subdomínio, como g1.globo.com e folha.uol.com.br, e têm robots.txt próprio.
Em cada arquivo procurei 26 nomes de robô: GPTBot, ChatGPT-User e OAI-SearchBot da OpenAI, ClaudeBot e os outros quatro da Anthropic, Google-Extended, CCBot do Common Crawl, PerplexityBot, Bytespider da ByteDance, Applebot-Extended, Amazonbot, meta-externalagent e mais uma dúzia. Classifiquei cada citação em três tipos: bloqueio total (Disallow: /), bloqueio parcial (algumas pastas) ou liberação explícita (Allow: / ou Disallow: vazio).
Uma ressalva que vale para o post inteiro: robots.txt é um pedido, não uma trava. O robô bem-comportado obedece. Bloqueio de verdade acontece no firewall, e isso a leitura de um arquivo público não enxerga.
O retrato geral
| Situação | Sites | Percentual dos 145 |
|---|---|---|
| Publicam robots.txt legível | 145 de 200 | |
| Não citam nenhum robô de IA | 105 | 72,4% |
| Citam algum robô de IA | 40 | 27,6% |
| Restringem pelo menos um (total ou parcial) | 30 | 20,7% |
| Bloqueio total de pelo menos um | 21 | 14,5% |
| Citam só para liberar | 10 | 6,9% |
| Bloqueiam todos os robôs, inclusive buscadores | 3 | 2,1% |
Dados verificados em 21/09/2026, top 200 de domínios .br da lista Tranco.
Os 55 que ficaram fora se dividem assim: 21 não responderam, quase todos domínios de infraestrutura que não têm site, como CDNs e servidores de DNS. Doze devolveram 404, ou seja, não têm o arquivo. Onze responderam 200 com outra coisa no lugar, em geral a página inicial, e vários são portais do governo e universidades. Nove recusaram a leitura com 403 ou 401.
Sete em cada dez grandes sites brasileiros não têm posição declarada sobre IA. Não é permissão consciente. É arquivo escrito antes de o assunto existir.
Quem barra, robô por robô
| Robô | De quem é | Bloqueio total | Bloqueio parcial | Liberado pelo nome |
|---|---|---|---|---|
| GPTBot | OpenAI, treino | 14 | 7 | 8 |
| ClaudeBot | Anthropic, treino | 12 | 5 | 7 |
| CCBot | Common Crawl | 16 | 0 | 7 |
| Google-Extended | Google, treino do Gemini | 10 | 4 | 14 |
| PerplexityBot | Perplexity | 8 | 6 | 10 |
| ChatGPT-User | OpenAI, navegação a pedido do usuário | 6 | 5 | 11 |
| OAI-SearchBot | OpenAI, busca | 4 | 6 | 5 |
| Bytespider | ByteDance | 9 | 0 | 1 |
Contagem entre os 145 sites com robots.txt, verificada em 21/09/2026.
O CCBot é o mais bloqueado em termos absolutos, e faz sentido: o Common Crawl é a base aberta que alimentou o treino de boa parte dos modelos. O GPTBot vem logo atrás quando se soma o bloqueio parcial.
Repare na última coluna. O Google-Extended é liberado pelo nome em 14 sites e bloqueado em 10. O ChatGPT-User é liberado em 11 e bloqueado em 6. Existe um grupo de sites que escreveu regra de IA para garantir que vai aparecer nas respostas, não para sumir delas.
Quem bloqueia tudo o que cita: uol.com.br com 23 robôs, amazon.com.br com 21, olhardigital.com.br com 16, glassdoor.com.br com 14 e jusbrasil.com.br com 13. Na outra ponta, a Lojas Renner cita 22 robôs e libera 21.
Por setor, a diferença é grande
| Setor | Sites com robots.txt | Citam IA | Restringem | Publicam llms.txt |
|---|---|---|---|---|
| Varejo e marketplace | 31 | 17 | 11 | 11 |
| Notícia e mídia | 27 | 11 | 9 | 9 |
| Educação e pesquisa | 16 | 2 | 2 | 1 |
| Governo e Judiciário | 15 | 0 | 0 | 0 |
| Banco e finanças | 11 | 2 | 2 | 2 |
| Telecom, hospedagem e tecnologia | 9 | 0 | 0 | 2 |
| Outros | 36 | 8 | 6 | 1 |
Classificação de setor feita por mim, a partir do domínio. Dados de 21/09/2026.
Nenhum dos 15 sites de governo e Judiciário com robots.txt cita robô de IA. Nenhuma empresa de telecom ou hospedagem também. Os dois setores que tomaram posição são os que vivem de conteúdo e de catálogo: mídia e varejo.
No varejo, a posição se divide ao meio. Amazon, Mercado Livre e Americanas bloqueiam. Netshoes, Dafiti, Drogaria São Paulo e Drogarias Pacheco liberam pelo nome. Quem vende produto tem um motivo concreto para querer ser lido: quando alguém pede a um assistente de IA uma recomendação de tênis, o catálogo que o robô conseguiu ler é o que entra na resposta.
Os portais de notícia não concordam entre si
Nos 20 endereços de notícia, 19 têm robots.txt, 11 citam robôs de IA e 7 bloqueiam.
| Veículo | Posição no robots.txt |
|---|---|
| O Globo, Valor | Bloqueio total de 19 e de 15 robôs, OpenAI incluída |
| Estadão | Bloqueio total de 8 robôs, OpenAI incluída |
| Gazeta do Povo, Olhar Digital | Bloqueio total |
| UOL, UOL Notícias | Bloqueio total de 23 robôs, sem citar o GPTBot |
| Folha | Bloqueio total de 21 robôs, com GPTBot, ChatGPT-User e OAI-SearchBot liberados pelo nome |
| Exame, R7, Correio Braziliense, Canaltech | Citam robôs de IA só para liberar |
| g1, Veja, CNN Brasil, Metrópoles, InfoMoney, Poder360, Estado de Minas, O Tempo | Nenhuma menção a IA |
Leitura de 21/09/2026.
Duas coisas chamam atenção. A primeira é o grupo Globo: O Globo bloqueia 19 robôs e o Valor 15, e o g1, do mesmo grupo e com audiência muito maior, não cita nenhum. A segunda é o par UOL e Folha. Os dois bloqueiam Anthropic, Google-Extended, Perplexity, Meta, Amazon, Apple e mais uma fila, e deixam a OpenAI de fora. Na Folha, a liberação é explícita: User-agent: GPTBot seguido de Allow: /. O arquivo não explica o motivo e eu não vou adivinhar. O que dá para afirmar é que não foi esquecimento, porque alguém escreveu a regra.
O llms.txt já apareceu em 26 sites
O llms.txt é uma proposta recente: um arquivo em Markdown na raiz do site que resume, para um modelo de linguagem, o que o site é e onde está o conteúdo que importa. Não é padrão oficial e nenhuma grande empresa de IA confirmou que usa. Mesmo assim, 26 dos 200 domínios já publicam um, 13% da amostra.
A lista tem nomes grandes: Itaú, Bradesco, Magazine Luiza, Americanas, Lojas Renner, Claro, KaBuM, O Boticário, MadeiraMadeira, Azul, Catho, RD Station, Alura e Jusbrasil. O do Itaú tem 39 KB e abre declarando o objetivo: ajudar sistemas de IA e agentes a identificar a área correta do ecossistema do banco. O da Renner tem 56 KB.
Três sites fazem as duas coisas ao mesmo tempo: Jusbrasil, Americanas e Gazeta do Povo bloqueiam robôs de IA no robots.txt e publicam llms.txt para orientá-los. Não é necessariamente contradição. A Americanas bloqueia o GPTBot, que coleta para treino, e libera o ChatGPT-User e o OAI-SearchBot, que buscam a pedido de um usuário. A mensagem é: não treine com o meu catálogo, mas me cite quando alguém perguntar.
Um único site dos 220, o Chaves na Mão, usa a diretiva Content-Signal, que declara o uso permitido em vez de nomear robôs: ai-train=no, search=yes, ai-input=yes.
O que isso muda para o site de um negócio pequeno
Se você tem um site de serviço local, de loja, de escritório, a conta é diferente da de um jornal. O jornal vende o texto. Você quer que o texto seja lido por qualquer coisa que possa mandar cliente. Bloquear robô de IA num site institucional tira o seu negócio das respostas de quem pergunta para o ChatGPT quem presta aquele serviço na sua cidade.
Se mesmo assim quiser separar treino de busca, o modelo da Americanas é o mais fino que vi na coleta:
User-agent: GPTBot
User-agent: CCBot
Disallow: /

User-agent: ChatGPT-User
User-agent: OAI-SearchBot
Allow: /
Para conferir o seu, abra seusite.com.br/robots.txt no navegador. Se der 404, você está no grupo dos 12 que não têm arquivo, e nenhum robô está barrado. Se o arquivo tiver User-agent: * com Disallow: /, você está barrando o Google junto, que foi o que encontrei em três dos 145.
O custo de usar esses modelos, para quem está do outro lado e quer consumir IA em vez de alimentá-la, está em chat, agente ou API: o que você está pagando na IA.
Limitações desta coleta
A lista Tranco mede domínio, não site. Por isso entram endereços de CDN e de DNS, que explicam boa parte dos 21 sem resposta. Subdomínios com robots.txt próprio só entraram no recorte de notícia. A classificação por setor é minha e tem uma gaveta grande de "outros". E a leitura é de um dia: robots.txt muda sem aviso.
De onde saiu cada número
- Lista Tranco, identificador 64X5X, baixada em 21/09/2026
- O
/robots.txte o/llms.txtde cada um dos 220 endereços, lidos em 21/09/2026 - Documentação dos robôs da OpenAI, para a diferença entre GPTBot, ChatGPT-User e OAI-SearchBot
- Proposta do llms.txt
A planilha da coleta
São 220 linhas com grupo, posição na lista Tranco, domínio, setor, se o robots.txt foi lido, o status HTTP, quantos robôs de IA o arquivo cita, a classificação de cada um dos 26 robôs, se usa Content-Signal e se publica llms.txt.
Baixar a planilha do robots.txt (.csv)Estes números valem para 21 de setembro de 2026. O próximo passo prático leva dois minutos: abra o robots.txt do seu site, veja se ele existe e se foi escrito por alguém ou gerado pela plataforma. Se você nunca tomou essa decisão, ela está tomada por omissão, do mesmo jeito que em 105 dos maiores sites do país.

